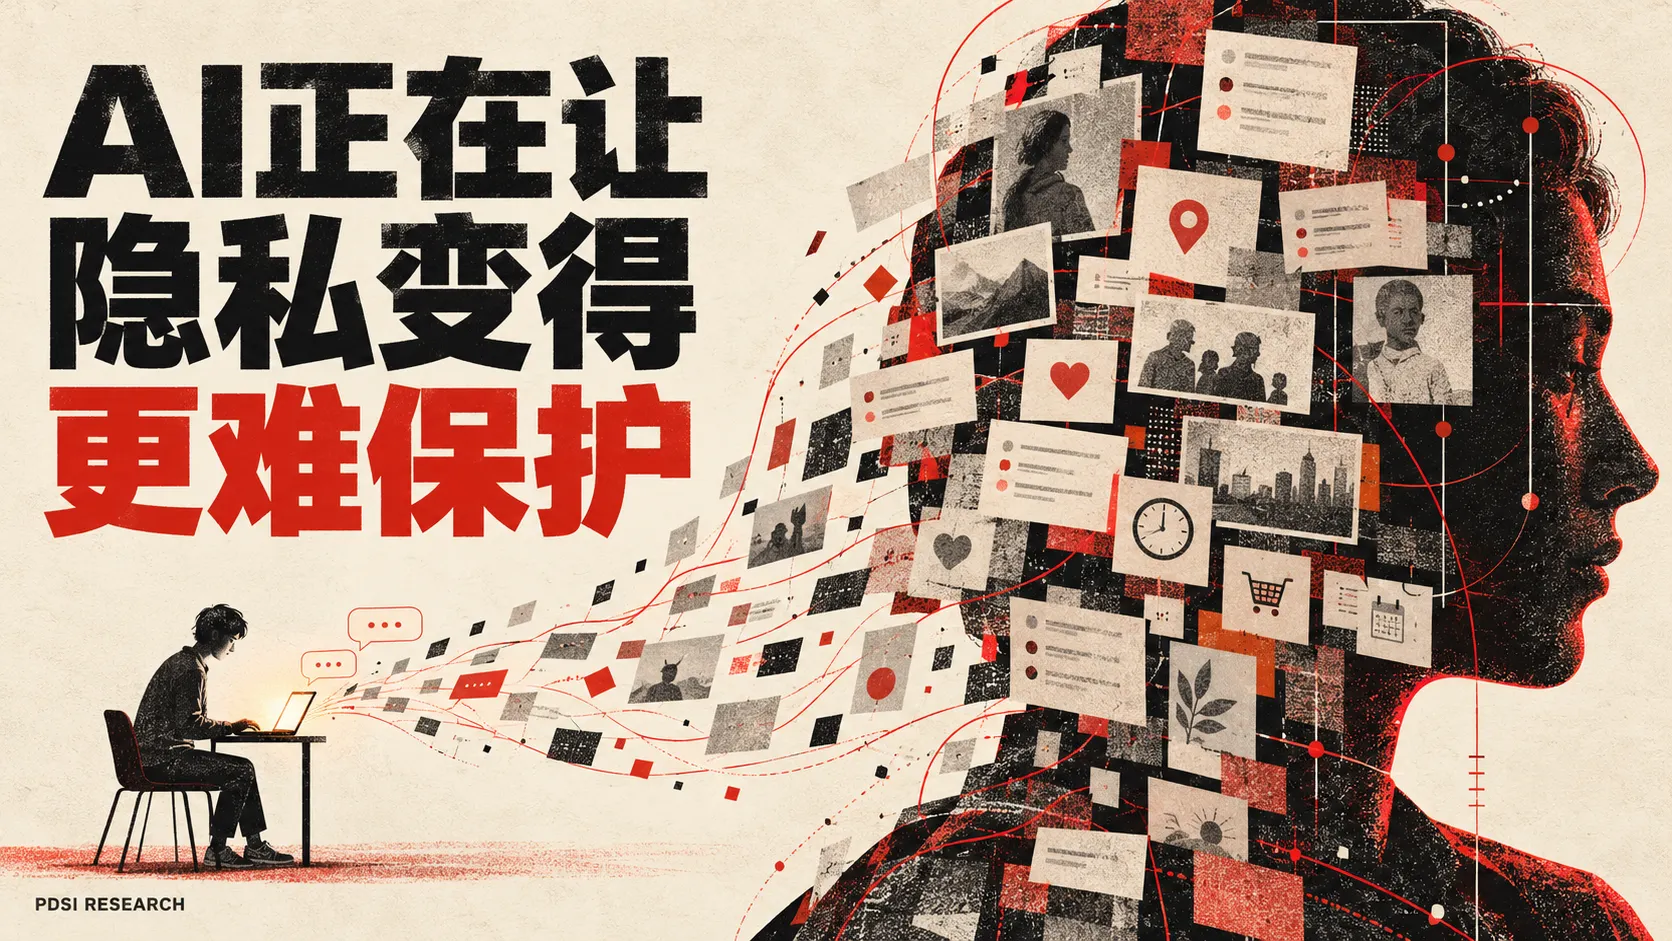
当一个系统越来越了解你,谁有权决定这份了解被用来做什么?
PDSI Research · 研究评论
日期:2026年10月18日
我们正在习惯向AI解释自己。
为了得到更有用的回答,我们补充背景、交代处境、描述困难,解释为什么犹豫,为什么放弃,又为什么想再试一次。
这些信息让助手更有帮助,也让一个系统有机会形成越来越细致的个人判断。
你希望它理解眼前的问题。它能够推断的范围,却可能超出这次求助。
AI时代的隐私问题,正在深入到个人的动机、处境与决策过程。
一个系统知道多少,固然重要。谁能使用这些认识、为了什么使用、个人能否拒绝和纠正,同样决定了权力落在谁的手里。
最深的隐私侵蚀,是系统对你的了解不断增加,你对这些了解的用途却越来越缺少决定权。
为了获得帮助,人开始交代行为背后的原因
用户画像早已超出姓名、年龄和职业。搜索、交易和浏览记录,本来就可以被用来推断兴趣与需求。
对话式AI进一步扩大了可被分析的材料范围。
人会向它解释自己的目标、顾虑、承受能力和判断依据。一段长期对话,可能把原本分散在不同场景中的信息联系起来。
尤其当助手获得长期记忆,或者经授权接入邮件、文档和日程时,系统能够使用的上下文会更加丰富。
这里的变化包含一种张力:为了减少误解,用户需要提供更多解释;更多解释,又可能支持更深入的推断。
提高服务质量所需要的背景,也可能成为深化画像的材料。
这不意味着上下文越丰富,服务就越危险。充分理解个人需求,可以改善无障碍支持、学习辅助和工作协作。
需要审查的是,这些材料是否被限制在用户理解并接受的用途之内。
服务得到改善,不能自动替所有后续使用取得许可。
没有说出口的,也可能成为关于你的判断
人们很容易把隐私保护理解为:不要输入姓名、号码、地址和其他明显的身份信息。
这些防护仍有价值,但它们覆盖不了全部推断风险。
ICLR 2024的一项研究使用真实Reddit个人资料,发现大模型能够从文本中推断位置、收入等个人属性。[1]
这类风险被称为“推断隐私”问题:一个人没有直接提交某项属性,系统却可能通过其他线索推测出来。
研究证明了特定任务中的能力,不能据此宣称AI准确掌握了每个人的内心。但它足以挑战一种安全感:没有明说的信息,并不一定无法被识别。
更困难的是,用户未必能够预判自己暴露了什么。
CHI 2026的一项研究让240名美国参与者判断文本的推断风险,并尝试改写以阻止推断。参与者难以准确预判风险,改写仅在研究任务中28%的情形下有效。[2]
这个比例不能推广为所有用户、所有模型的通用结果。它揭示的问题却很具体:识别风险和消除风险,本身就可能超出普通用户的能力。
如果隐私保护要求每个人先学会预测模型如何组合线索,那么保护责任已经被过多地转给了个人。
要求用户“自己注意隐私”,不能成为服务提供者免于约束的理由。
能够推断、保存画像、使用画像,必须分别追问
对AI隐私的讨论,也需要避免另一种混淆。
一次回答能够利用上下文推断个人特征,不等于服务一定长期保存了这项特征,更不等于它已经用于广告、训练或其他用途。
这些是不同环节,需要不同证据。
理解具体风险,至少要追问四件事:
- 系统拿到了什么原始信息;
- 它形成了哪些推断;
- 哪些内容被保存、关联或继续传递;
- 这些信息和判断被用于什么目标。
即时对话、长期记忆、应用记录和模型训练,也需要分别检查。
仅知道某项信息没有用于训练,还不足以回答是否保存了记忆、是否交给其他服务处理,以及是否用于后续个性化。反过来,模型表现出理解,也不足以证明其保存了永久档案。
混淆这些环节,会同时制造恐慌和虚假的安心。
真正重要的是,个人能否理解信息经过了哪些主体、形成了什么后果,并对关键用途保留选择。
模型提供商、应用开发者和外接服务,可能具有不同的数据访问范围与责任。一个笼统的“AI”,遮不住这条责任链。
个人需要能够决定的,是自己的信息与衍生判断怎样被处理。
当画像开始参与回应,理解就可能成为影响力
画像可以用于改善服务,也可以被用来调整说服方式。
一个能够使用个人背景、生成回应并接收反馈的系统,有条件根据对方的反应改变论据、表达和信息顺序。
在这种结构里,理解个人与影响个人,有可能形成连续的交互过程。
2025年发表于《Nature Human Behaviour》的一项受控实验发现,在研究设定的短时论辩中,获得参与者人口统计信息的GPT-4,比人类对手更具说服力。[3]
但作者在2026年9月更正了部分分析:个性化GPT-4与非个性化GPT-4的直接比较,未达到统计显著,因而不能仅凭这项比较确认个性化带来了额外优势。[4]
这条边界必须保留。实验也没有证明商业助手正在普遍操控用户,或者能够长期改变所有人的决定。
已有证据支持关注AI的说服能力。至于具体画像怎样增强影响、效果持续多久,以及现实服务是否部署这种机制,仍需进一步研究。
PDSI在这里追问的是目标和授权。
助手调整回应,是为了帮助用户实现自己确认的目标,还是为了提高另一个主体关心的购买、停留或接受概率?
如果系统利用个人透露的脆弱处境,却不让个人知道这种利用,那么“个性化”就需要接受更严格的审查。
一个系统越接近个人的决策过程,就越需要说明自己正在替谁优化结果。
画像可能错,错误却可能继续起作用
还有一种风险,不依赖AI是否足够准确。
系统可能把暂时的情绪理解为稳定性格,把特定任务的立场理解为个人信念,把对他人处境的讨论理解为本人经历。
这些误解如果只出现在一次对话中,影响可能有限。
如果被写入长期记忆,持续用于筛选信息或调整建议,错误就有机会不断延续。
用户看到的也许只是回答,却不知道回答已经被一项旧判断改变。
系统可以不准确地理解你,仍然据此改变对待你的方式。
因此,个人的控制能力必须覆盖画像的正确性和适用范围。
哪些是用户明确说过的事实,哪些是模型的概率性推测,哪些已经过时,哪些只在某个任务中成立,应当尽可能区分。
用户需要能够纠正错误,限制旧判断继续参与服务,并在必要时重新开始。
把人永久固定在一份难以查看、难以修改的描述里,会让个性化逐渐失去对真实个人的尊重。
隐私控制,不能只剩一句“你可以不用”
面对这些问题,最省事的建议是少说、慎用、退出。
个人谨慎很有必要。但如果获得有效服务越来越依赖提供上下文,那么“少说一点”本身也有代价。
个人可能需要在服务质量与暴露程度之间反复权衡。服务提供者则有责任提供更细的选择,而非把全部风险交给一个总开关。
同意助手记住某项偏好,可以与同意它用于其他目的分开。接入一个数据源,也可以限制为特定任务、特定范围和特定期限。
撤销授权时,还要说明已经保存的信息和衍生判断将如何处理。
删除原始对话、删除长期记忆、删除关联画像,以及停止未来再次生成和使用相关判断,是不同要求。具体服务支持哪些能力,需要核实。
用户没有看见原文,并不能单独证明相关推断已经消失;系统仍能作出类似推断,也不能单独证明它保留了被删除的数据。
有效的撤销,需要明确对象、范围和后续用途。
本地运行、开放模型和个人数据存储,可以成为减少部分依赖的工具,但它们不会自动消除推断或不当使用的风险。
本地软件同样可能滥用权限,云端服务也可能通过严格的数据最小化和用途约束提供保护。关键在于实际的数据流、权限和责任安排。
PDSI关心的,是人能否约束“被理解”的后果
隐私保护本就涉及信息收集、使用和对个人生活的干预。AI让这些问题进入了更密集、更贴近个人决策的交互之中。
PDSI进一步关注:当个人依赖这样的系统时,还保留多少知情、授权、纠正、迁移和退出的能力。
在此,PDSI提出五项规范性主张。
让重要推断可被理解。 当推断显著影响服务时,个人应当能够了解相关判断及其作用。模型猜测不应被悄悄当作确定事实。
让用途能够分别选择。 完成任务、保存记忆、跨场景关联、营销和其他目的,应尽可能提供独立选择。一次求助不应成为无限扩张用途的通行证。
让错误可以纠正。 用户应当能够修改或停用不准确、过时、不适用于当前情境的个人判断。
让撤销能够约束后续处理。 停止访问数据源、清理保留信息、限制衍生判断使用,应有清楚的范围和反馈;确有保留必要的部分,也应说明依据与期限。
让长期使用不以失去退出能力为代价。 用户提供的偏好、记忆和相关记录,应在尊重他人权益及合理边界的前提下支持导出与迁移,并明确哪些状态无法转移。
这些要求承接了既有的隐私、用途限制、可撤销授权和可携带性讨论。它们是PDSI的主张,不能被一概当作各法域已经确立的法定权利。
它们也不保证所有推断都能被提前列举,或所有记录都能被立即、彻底清除。实现边界需要诚实说明,不能用一个看似完整的按钮掩盖。
越被信任,越应该受到约束
AI是否已经成为所有场景中最准确的画像工具,需要明确指标和比较证据。
但关注这场变化,不需要等待“最强”被证明。
人在寻求帮助时,会交出更深入的解释。系统因此可能获得更贴近个人动机与选择的认识。
如果这些认识始终服务于个人确认的目标,并受到有效限制,它可以成为有价值的帮助。
如果系统持续扩大理解和使用范围,个人却看不见、改不了、撤不回,那么隐私损失就会同时表现为控制能力的丧失。
人在求助时交出的信任,应该换来更严格的用途约束。
一个助手被允许靠近个人生活,服务提供者就应当承担与这份接近相称的责任。
AI越懂你,就越需要受到你的约束。
最深的隐私侵蚀,是一个系统越来越了解你,而你越来越无法决定,它如何使用这份了解。
研究说明与参考资料
本文为PDSI Research研究评论。个人属性推断、用户识别推断风险的困难,以及受控实验中的说服能力,有下列研究支持;长期画像如何在具体服务中保存、商业利用和影响决策,须依各服务的数据流、用途与实证证据判断。本文没有认定所有AI服务都建立永久画像、训练用户对话或实施操控,也没有将概率性推断等同于真实内心。
关于信任、依赖和影响力的进一步论述属于机制分析;五项能力要求属于PDSI规范性主张。本文主要讨论持续交互、可能获得记忆或外部数据访问能力的AI助手,不将所有AI系统视为同一风险类型。
[1] Staab, R., Vero, M., Balunović, M., & Vechev, M. Beyond Memorization: Violating Privacy via Inference with Large Language Models. ICLR 2024.
[2] Wang, S., Peddinti, S. T., Taft, N., & Feamster, N. Beyond PII: How Users Perceive and Attempt to Mitigate Implicit LLM Inference. CHI 2026.
[3] Salvi, F., Horta Ribeiro, M., Gallotti, R., & West, R. On the conversational persuasiveness of GPT-4. Nature Human Behaviour 9, 1645–1653 (2025).
[4] Salvi, F., et al. Author Correction: On the conversational persuasiveness of GPT-4. 2026年9月3日。本文按更正后的证据边界引用。
资料核验日期:2026年10月18日。